链上数据(onchain data) ,按 Ledger 的定义,是“写入区块链的每一笔交易、每一次转账和每一次智能合约交互的永久、公开记录”。通俗地说,它像一本放在公共广场上的账本:谁转了多少、转到哪个地址、付了多少手续费、在哪个时间点被确认,这些动作本身被网络记了下来,任何人都可以翻开核对。
但这里有一个新手最容易忽略的分界线。Ledger 在同一词条中明确指出:链上数据不包含“解读” 。一笔交易只能显示“地址 A 向地址 B 发送了代币”,它并不告诉你这两个地址分别由谁控制,也不解释转账的原因。把原始记录变成“巨鲸在卖出”“交易所流出激增”这样的结论,中间经过了解码、地址标签、聚类算法和阈值设定等多层加工。
所以,链上数据值得了解,不是因为它“什么都告诉你了”,恰恰相反:它是你在面对各种解读时,唯一可以回去独立核对的那一层底稿。理解它的价值,同时理解它的边界,才是使用链上数据的起点。
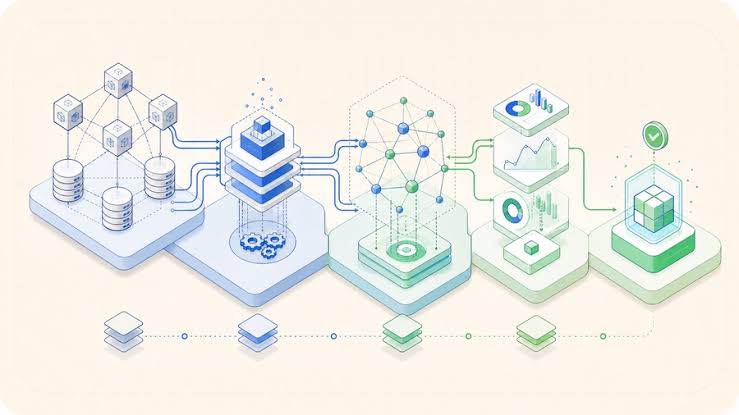
大多数区块链的链上数据可以拆成三个相互关联的层次。
交易层是最基础的一层,记录价值从一个地址移动到另一个地址、手续费多少、由哪把密钥签名授权。它能回答“某笔转账是否发生、金额多少、何时确认”;不能回答“这笔转账是卖出、抵押、内部划转,还是别的什么目的”。
状态层反映每个地址在某一时刻持有的资产数量。余额是交易累积的结果。它能回答“这个地址现在持有多少代币”;不能回答“这个余额是否属于同一个人、是否被锁定或已用作抵押”。
当交易触发智能合约时,合约会生成事件日志,记录程序执行过程中的状态变化。它能回答“某个 DeFi 协议是否发生了一笔借贷或兑换”;不能自动回答“这笔操作背后的用户意图是什么”,需要结合合约逻辑和外部信息来解码。
三层之间的关系是:交易触发状态变化,合约事件是状态变化在程序层面的“日志” 。分析者把三层拼在一起,才有机会接近一个可读的图景;但拼图本身仍然不等于全貌。
链上数据不是唯一有用的数据。价格、身份记录、交易所内部账本、用户意图,大多在链下。二者最关键的差别不在于“谁更真实”,而在于验证方式不同。
| 维度 | 链上数据 | 链下数据 |
|---|---|---|
| 验证方式 | 运行节点即可独立核对 | 通常依赖持有数据的机构或第三方 |
| 典型内容 | 转账、余额、合约事件 | 价格、身份、交易所内部成交、用户意图 |
| 主要局限 | 不含身份与动机,地址可被一人批量制造 | 外部人难以独立验证 |
| 在分析中的角色 | 可验证的“底稿” | 提供背景与解释 |
这张表说明:链上数据的强项是可独立验证,而不是“自动可理解”。一笔链上转账可以被任何人核对,但“这笔转账意味着什么”,往往需要链下背景来补足。成熟的链上分析,通常是两者结合,而不是用其中一方替代另一方。
区块浏览器是新手最直接的入口。以以太坊的 Etherscan 为例,不需要账户,把交易哈希或钱包地址粘贴到搜索栏,就能看到交易状态、金额、手续费、时间戳和合约交互记录。它回答的是单笔记录层面的问题:“这笔交易到底有没有确认”“这个地址转出了什么”。它给不了的是:地址背后是谁、这笔转账属于什么策略。
在单笔记录之上,Glassnode、Nansen、Dune 等工具把大量地址和交易聚合成指标。它们的分工并不相同:Glassnode 偏向宏观周期与持币者行为指标,适合看长期结构;Nansen 以钱包标签和“聪明钱”追踪见长,但它标注的是“行为分类”,不是官方身份;Dune 提供 SQL 查询和社区仪表板,灵活性最高,但需要一定的数据查询能力。
节点通过 RPC 接口对外提供链上状态和交易数据,索引服务则把原始区块和事件日志解码成更易查询的结构。这一步回答的是“某个合约在特定时间窗口内发生了多少次特定事件”这类问题,门槛更高,适合有明确查询需求时再进入。
标签是分析平台对地址做的分类,比如“交易所”“基金”“做市商”。它让匿名地址变得可读,但标签本质上是带日期的假设:服务商可能更新不及时,同一地址在不同平台可能得到不同标签,聚类算法也只是启发式推断。标签是线索,不是身份证。
链上数据的一个根本特征是:记录本身可以被低成本地生产出来,但“生产记录”不等于“产生真实需求”。
a16z crypto 在 2025 年的 State of Crypto 报告中测到约 1.81 亿个月度活跃地址,但同时估计背后的真实月度用户只有 4000 万到 7000 万。Linea 在 2025 年 1 月与 Nansen 合作筛查时,将约 130 万个空投资格地址中的约 40% 标记为疑似女巫地址,即便这些地址已经通过了“人格证明”。LayerZero 此前也曾将超过 80 万个地址标记为疑似为 farming 奖励而创建的女巫地址。
这些数字不是在说“链上数据没用”,而是在说:地址数量、交易笔数这些表面指标,需要经过女巫过滤和实体聚类之后才有讨论价值。如果直接把“活跃地址创新高”读成“真实用户在涌入”,结论的边界就被越过了。
欧易的一篇讨论记录了一个典型案例:交易所新增一个热钱包,资金从冷钱包挪入,但工具的标签尚未更新,于是被读成“一大笔资金流出交易所”。地址是真的,转账是真的,只有结论错了。
这不是孤例。同一个地址可能被不同平台给出不同标签;同一笔转账算作“内部划转”还是“净流出”,取决于工具是否知道那个地址属于谁。交易所净流量指标尤其依赖地址标签的质量,而标签更新存在时滞。Koin Bülteni 的指南也提醒:一笔充值进入交易所,不必然等于卖出,它可能是补充抵押品、为衍生品账户注资,或者只是交易所内部的钱包整理。
因此,看到“净流出 X 亿美元”时,至少需要追问:用的是哪个平台的标签?标签的时间戳是什么?这笔转账的发送方和接收方是否被正确归类?没有这些信息,“流出”只是一个待验证的假设,不是可以直接使用的结论。
MVRV(市值/已实现市值)常被用来描述持币者的整体盈亏状态:明显高于 1 通常意味着持有者平均处于盈利,低于 1 则平均处于亏损。它适合回答“当前周期状态下,持有者整体是盈是亏”,但不适合被当成精确的择时按钮。有研究指出,某些链上阈值(例如 MVRV 超过 3.7 被视为“高估”)来自数量有限的周期样本,样本量本身限制了阈值的稳定性。
国际清算银行的一份报告也讨论过链上转账量被高估的问题,指出部分依赖转账量的指标需要叠加钱包标签、行为聚类和链下上下文才能保持解释力。这不是否定指标的价值,而是说明:任何单一指标都只是对复杂系统的一个切面,切面之间的分歧本身就是信息,不应该被强行抹平。
1、我只是普通用户,需要看链上数据吗?
不必每天都看。但如果你持有链上资产,至少学会用区块浏览器核对一笔交易是否确认,这是最基础也最可靠的能力。
2、工具显示“巨鲸在卖出”,我能直接跟着做吗?
不能。“巨鲸”地址可能属于托管方、做市商或交易所内部钱包,一笔转出也不等于卖出。工具给出的是行为线索,不是已经完成的交易意图。
3、链上数据能直接查到“是谁”吗?
不能。链上记录只显示地址和余额变化。地址背后的真实控制者通常需要链下证据,例如交易所 KYC、司法调取或平台标签,而标签本身也是推断。
4、为什么不同平台对同一件事给出相反结论?
因为它们的标签体系、聚类方法和阈值不同。同一个地址在 A 平台被标为交易所,在 B 平台可能未被识别;同一笔转账在一处算内部划转,在另一处算净流出。分歧是常态,不是异常。
5、初学者应该从哪些指标开始?
先从单笔交易和地址余额开始,理解“记录层面”能告诉你什么。然后接触一两个聚合指标(如交易所净流量、活跃地址),并同时阅读该指标的方法论说明,而不是只看图表标题。
6、链上数据分析需要编程能力吗?
不一定。区块浏览器和 Glassnode 这类预制仪表板不需要编程;Dune 的自定义查询需要 SQL。门槛取决于你想回答的问题有多具体。
7、如何判断一个“链上数据显示”的结论靠不靠谱?
先问三件事:它用的是记录还是解读?标签和阈值有没有写明来源和时间?有没有用第二个独立来源交叉核对?三个问题中有一个答不上来,结论就应该暂时悬置。
没有下一篇了
相关教程
更多热门教程
更多热门软件
更多最新教程
更多链上数据是什么意思?怎么看链上数据?2026链上链下区别、三层结构、工具用法全解析
币圈涨跌受什么影响?本轮下跌该怎么抄底?
koru是什么股票,koru股票是三倍做多韩国股市吗?哪里可以购买
美联储加息对币圈有什么影响?2026加息传导路径、资产分化、历史三阶段与关键观察指标全解析
美股这一轮会上涨吗?美股在交易所怎么买?
山寨币为什么价格波动大?该如何正确购买山寨币?
质押是什么意思?虚拟货币质押怎么赚钱?2026质押分类、收益来源
珍珠币PRL(Pearl)是什么?珍珠币挖矿详细规则与教程解析
比特币现货和合约的区别是什么,现货和合约哪个好?附购买教程
合约止盈止损怎么设置最合理?合约止盈止损的最高技巧解析
软件排行榜
更多